세션 목록
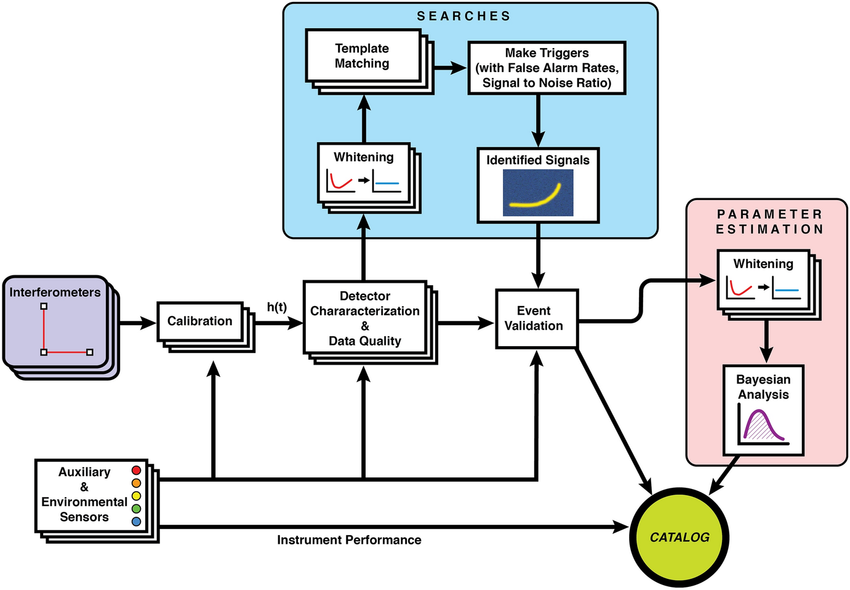
베이지안이란?
중력파 신호에서 질량, 거리, 스핀 등의 파라미터를 추출하는 것은 역문제(inverse problem)입니다. 관측된 데이터 d가 주어졌을 때, 어떤 파라미터 θ가 이를 만들었을지 추론합니다.
베이즈 정리 — 정의와 유도
두 사건 A, B가 있다고 합시다. 조건부 확률의 정의에 따르면, “B가 일어났을 때 A가 일어날 확률”은 둘이 동시에 일어날 결합확률 P(A,B)를 B의 확률로 나눈 것입니다:
같은 논리로, “A가 일어났을 때 B가 일어날 확률”도 같은 결합확률로 정의됩니다:
두 식의 분자가 똑같이 P(A,B)이므로, 이를 소거하면 베이즈 정리가 나옵니다:
파라미터 추정에서는 A = d(관측 데이터), B = θ(알고 싶은 파라미터)로 놓으면 원하는 식이 됩니다:
아래에서 각 항을 클릭해 정의와 의미를 확인해 보세요:
베이즈 정리의 의미
결국 베이즈 정리는 사전 지식을 새 데이터로 갱신하는 것입니다. 데이터를 보기 전에는 파라미터 θ(질량·스핀·거리 등)에 대해 물리적으로 가능한 범위만 아는 사전 확률 P(θ)뿐이지만, 데이터 d를 관측하면 그 지식이 사후 확률 P(θ|d)로 갱신됩니다. 이때 갱신 방향과 정도를 결정하는 것이 우도 P(d|θ)입니다 — θ가 참일 때 지금 본 데이터가 나올 법할수록, 확률은 그 θ 쪽으로 쏠립니다. 중력파 관측에서 θ는 뒤에서 볼 15개 파라미터(BBH 기준)의 조합, d는 검출기 네트워크의 변형률 데이터이며, 베이즈 정리는 이 둘을 실제로 가장 잘 맞아떨어지는 θ로 확률을 재분배하는 절차입니다.
탐정의 비유로 이해하기 — 베이즈 추론은 탐정이 사건을 푸는 방식과 닮았습니다. 단서(데이터)를 보기 전, 탐정은 여러 용의자에게 저마다 다른 그럴듯함을 부여합니다(사전 확률). 새 단서가 나올 때마다 “이 용의자가 범인이라면 이 단서가 나올 법한가?”를 따져(우도), 그 정도에 비례해 심증을 갱신합니다(사후 확률). 단서를 하나씩 쌓아 갈수록 의심은 실제 범인 쪽으로 점점 좁혀지죠 — 검출기 데이터를 더 정밀히 분석할수록 파라미터 θ의 사후 분포가 점점 뾰족해지는 것과 정확히 같은 원리입니다.
우도 함수
파라미터 θ에서 예측되는 파형과 실제 데이터가 검출기 k별로 얼마나 일치하는지를, 각 검출기의 PSD 로 가중해 모든 검출기·주파수에 대해 합산한 것입니다.
사전 확률(Prior)은 어떻게 정해지는가
우도가 “데이터가 이 θ를 얼마나 지지하는가”를 말해준다면, 사전 확률 π(θ)는 데이터를 보기 “전”부터 이미 알고 있는 물리적 지식을 담습니다. 실전에서는 15개 파라미터(BBH 기준)를 대부분 독립으로 두고, 각 파라미터의 분포를 따로 곱하는 분리형 사전을 사용합니다. 대표적인 선택은 다음과 같습니다 (Romero-Shaw et al. 2020, §3.1–4.1 & Appendix B2):
- 성분 질량 m₁, m₂: 물리적으로 가능한 범위(예: 1~100 M☉)에서 균일(uniform)
- 광도 거리 d_L: 우주에 균일하게 퍼진 광원을 가정해 코모빙 부피에 균일하게 분포한다고 가정 — 단순히 d_L 값 자체에 균일 분포를 주지 않음
- 하늘 위치(α,δ), 편광각 ψ, 경사각 ι: 등방(isotropic) — 특정 방향을 미리 우선하지 않음
- 스핀 방향: 등방, 스핀 크기: 균일
사전 분포의 선택은 사후 분포 결과에 직접 영향을 주기 때문에, 논문에서 측정값을 인용할 때는 항상 어떤 사전 분포를 가정했는지 함께 명시합니다.
파라미터 추정 파이프라인
지금까지 베이즈 정리·우도·사전 확률을 하나씩 따로 살펴봤다면, 이제 이 조각들이 실제로 어떻게 맞물려 사후 분포를 만들어내는지 전체 흐름을 보겠습니다 — 데이터가 어떻게 사후 분포로 바뀌는지, 다섯 단계로 요약하면 다음과 같습니다:
탐색 공간
위 1단계(입력 준비)에서 말한 파라미터 θ가 정확히 무엇으로 구성되는지부터 살펴보겠습니다. BBH 파라미터 추정에서 실제로 샘플링하는 파라미터는 15개입니다. 이들을 두 그룹으로 나누는 기준은 천체 자체의 물리적 성질인지, 아니면 그 신호가 지구에 어떻게 도달했는지에 관한 것인지입니다. 이 기준은 검출기가 실제로 받는 신호의 수식에 그대로 드러납니다.
아래에서 각 항을 클릭해 무엇을 의미하는지 확인해 보세요:
- 내인적(intrinsic) 파라미터는 파형 h₊, h×의 “내용” 자체를 결정하는, 관측 방향과 무관한 발원지 고유의 물리량입니다 — 질량·스핀이 바뀌면 파형의 주파수 변화·진폭·위상 구조가 전부 달라집니다. 성분 질량 m₁, m₂, 스핀 크기 a₁, a₂, 스핀 방향각 tilt₁, tilt₂, φ₁₂, φ_JL 총 8개입니다.
- 외인적(extrinsic) 파라미터는 이미 정해진 h₊, h×가 “지구에서 어떻게 관측되는지”를 결정합니다 — 파형의 모양이 아니라 관측되는 크기·시점만 바꿉니다. 하늘 위치(α,δ)·편광각(ψ)은 안테나 응답 함수 F₊,ₓ로 신호에 곱해지고, 거리는 진폭을 1/d_L로 축척하며, 합병 시각·위상은 도착 시점을 정합니다. 광도 거리 d_L, 하늘 위치 α, δ, 편광각 ψ, 경사각 ι, 합병 시각·위상 t_c, φ_c 총 7개입니다.
이 구분이 실제로 중요한 이유: 내인적 파라미터는 블랙홀의 질량 분포·형성 경로 등 천체물리학 정보를 담고 있고, 외인적 파라미터는 전자기파 대응체를 찾기 위한 하늘 위치나 허블 상수 측정을 위한 거리처럼 다중신호 관측·우주론 연구에 직접 쓰입니다.
내인적 8개 + 외인적 7개, 총 15개 파라미터의 공동 사후 분포를 추정합니다!
이 15개는 BBH 기준이며, BNS(중성자별 쌍성)는 여기에 두 별 각각의 조석 변형도 Λ₁, Λ₂가 추가되어 총 17개가 됩니다. 실제로 BNS 파형 모형 IMRPhenomPv2_NRTidal은 (조석 소산 항을 제외한 표준형 기준) 정확히 17개의 파라미터에 의존한다고 명시되어 있습니다 (출처: Ripley, Hegade K.R., Chandramouli & Yunes 2024, arXiv:2312.11659 — “A constraint on the dissipative tidal deformability of neutron stars”, §I: “Without tidal dissipation, the IMRPhenomPv2_NRTidal model depends on 17 parameters”).
감을 잡기 위해, GWTC-3 카탈로그에 실제로 실린 측정값을 아래 토글에서 살펴보세요:
실제로 GW150914 자체의 질량 사후 분포는 어떤 모습이었을까요? 논문에 실린 그림을 그대로 보겠습니다:
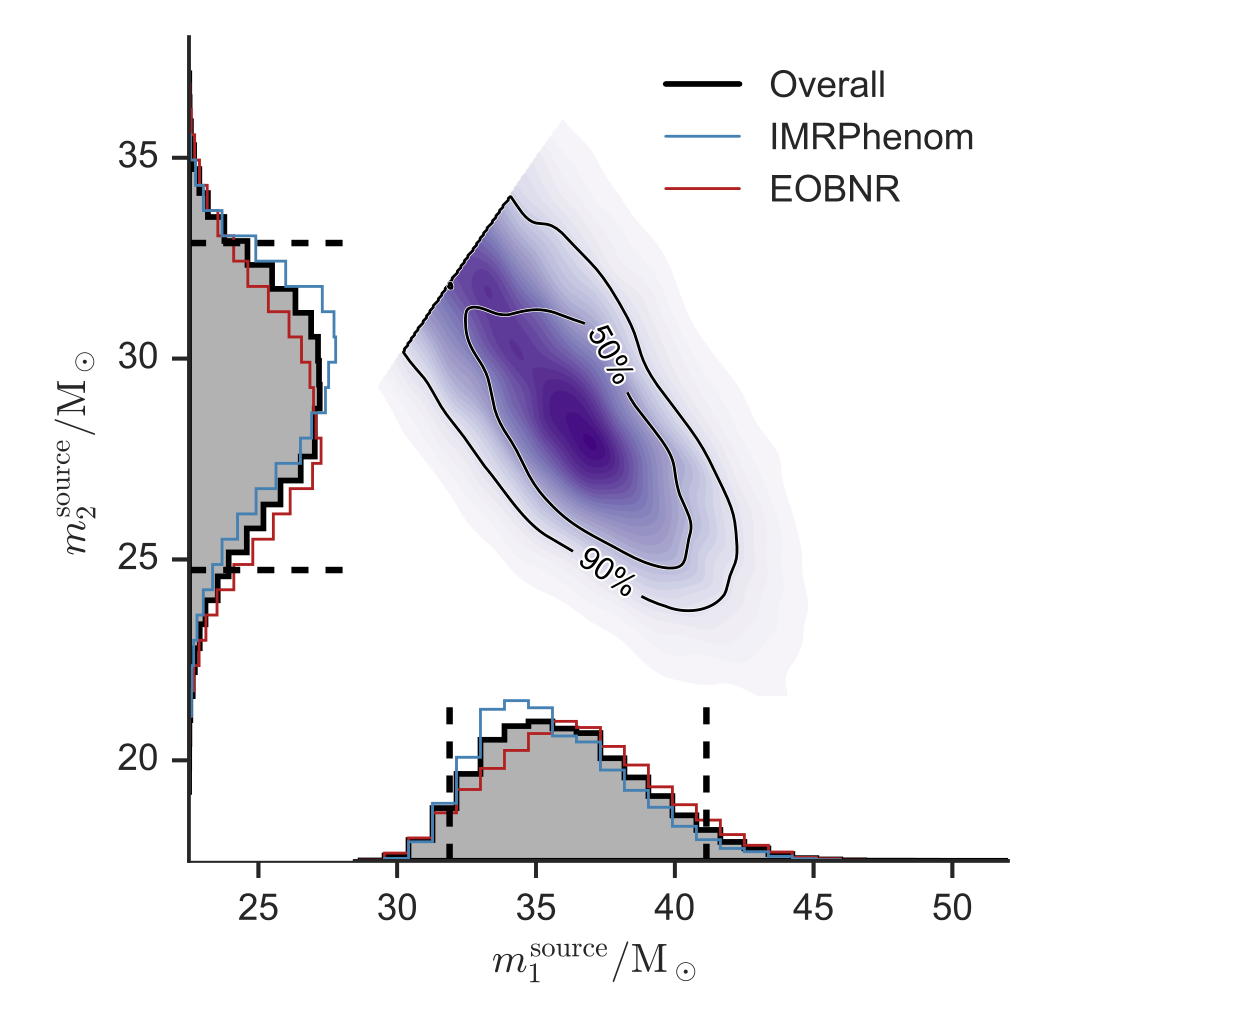
Figure 1 — GW150914 원시 천체 질량 m₁ˢᵒᵘʳᶜᵉ, m₂ˢᵒᵘʳᶜᵉ에 대한 사후 확률 분포. m₂ ≤ m₁ 관례를 사용해 2차원 분포에 날카로운 경계가 생긴다. 1차원 주변 분포는 Overall(검은 실선), IMRPhenom(파랑), EOBNR(빨강) 세 파형 모형의 결과를 겹쳐 보여주며, 점선은 Overall 분포의 90% 신뢰구간 경계다. 2차원 그림은 색으로 표현된 확률밀도 위에 50%·90% 신뢰영역 등고선을 그린 것이다.
출처: Abbott et al. 2016, arXiv:1602.03840, Fig. 1 ↗
바로 앞서 본 GW200129의 표·그림과 같은 형태 — 1차원 주변분포와 2차원 등고선 조합 — 임을 알 수 있습니다. 이런 사후 분포를 어떻게 계산하는지 이어서 살펴보겠습니다.
어떻게 사후 분포를 계산하는가
15차원 공간에서 사후 분포를 직접 적분해 구하는 것은 사실상 불가능합니다. 그래서 무작위로 파라미터 후보를 계속 제안·시험하면서 확률이 높은 영역을 자동으로 더 자주 방문하는 샘플링 기반 알고리즘을 씁니다:
- MCMC (Markov Chain Monte Carlo): 현재 위치에서 근처의 새 후보를 무작위로 제안한 뒤, 후보의 우도×사전확률이 더 크면 항상 옮겨가고 작더라도 그 비율만큼의 확률로 가끔 옮겨갑니다(Metropolis–Hastings 규칙). 수백만 번 반복하면 방문한 위치들의 분포가 사후 분포로 수렴합니다 — 산을 오를 때 대체로 위로 걷되 가끔 아래로도 내려가며 지형 전체를 탐색하는 것과 비슷합니다.
- 네스티드 샘플링 (Nested Sampling): 사전 분포 전역에 점들을 흩뿌려 놓고, 매 단계 우도가 가장 낮은 점을 제거하면서 점점 더 높은 우도 영역으로 탐색 범위를 좁혀갑니다. 이 과정에서 “우도 부피가 줄어드는 속도”를 추적하면 모델 비교에 핵심적인 증거 Z까지 함께 얻을 수 있다는 점이 MCMC 대비 큰 장점입니다.
LIGO·Virgo·KAGRA에서 실제로 쓰이는 도구들: 대표적인 파이프라인에 대한 자세한 설명은 아래 토글을 참고하세요.
| 도구 | 방법론 | 특징 | 공식 코드 |
|---|---|---|---|
| Bilby + dynesty | 동적 네스티드 샘플링 | 가장 널리 쓰이는 표준 파이프라인. 모듈식 설계로 다양한 샘플러·파형 모델을 자유롭게 조합할 수 있음 | Bilby · dynesty |
| LALInference | MCMC(+네스티드 샘플링) | O1–O2 시기 표준 파이프라인이었던 레거시 도구. LALSuite에 포함되어 배포됨 | LALSuite |
| RIFT | 격자(grid) 기반 반복 피팅 | 고차원 파라미터 공간을 저차원 조각으로 나눠 병렬 처리. 여러 파형 모델을 빠르게 비교하는 데 강점 | RIFT |
| 머신러닝 기반 PE (예: Dingo) | 정규화 흐름(normalizing flow) 신경망 | 학습된 신경망이 수 초 내에 사후 분포를 직접 출력. 정밀도를 다소 희생하는 대신 압도적으로 빨라, 중성자별 합병처럼 신속한 후속 관측(전자기파 대응체 탐색)이 중요한 이벤트에 유용 | Dingo |
베이지안 추론에서 모수 추정으로
지금까지 다룬 파이프라인이 베이즈 정리 전체 중 정확히 어떤 갈래였는지 마지막으로 짚어보겠습니다. 첫 세션의 베이즈 정리를 데이터 d와 모델 M에 대해 다시 쓰면:
는 증거(Evidence)로, θ에 의존하지 않는 상수라 사후 분포의 “모양”만 필요한 모수 추정에서는 몰라도 됩니다 — 지금까지 우도 유도가 늘 Z를 생략해온 이유입니다. 하지만 서로 다른 모델 , 를 비교할 때는 반대로 이 Z 자체가 핵심이 됩니다:
이는 Christensen & Meyer (2022), §III.C, Eq. 8–9의 베이즈 인자 정의 — 사후 오즈를 사전 오즈로 나눈 값 — 를 사후 오즈에 대해 다시 정리한 것과 같습니다. 좌변인 사후 오즈(Posterior Odds)는 데이터를 본 후 두 모델의 상대적 신뢰도이며, 우변의 베이즈 인자(Bayes Factor)가 그중 “데이터 자체의 지지 정도”만을 분리해 보여줍니다.
즉 모수 추정과 모델 비교는 같은 베이즈 정리에서 나온 두 얼굴이며, 이 페이지가 지금까지 다룬 파이프라인은 그중 첫 번째 갈래였습니다. 두 번째 갈래(모델 비교)가 정확히 어떻게 작동하는지, 그리고 방금 “몰라도 된다”고 넘어간 증거 Z를 실제로 계산하려면 왜 어려운지는 아래 토글에서 살펴보세요:
실습 노트북 → Tuto 5.1: An Introduction to Parameter Estimation — 베이즈 정리의 기초부터 거부 샘플링(rejection sampling)·MCMC 실습, 그리고 베이즈 인자로 두 모델을 실제로 비교하는 문제까지 직접 코드를 실행하며 익힐 수 있습니다.
사후 분포 해석
사후 분포의 출력 형식
샘플러(MCMC·네스티드 샘플링)가 실행을 마치면 결과물은 하나의 커다란 표(table)입니다. 행 하나가 사후 표본 하나이고, 열은 각 파라미터입니다:
| ra | dec | mass_1_source | mass_2_source | luminosity_distance |
|---|---|---|---|---|
| 1.2832 | -1.2029 | 37.73 | 28.00 | 458.43 |
| 1.1269 | -1.1745 | 36.87 | 30.55 | 403.44 |
| 1.6658 | -1.2815 | 31.68 | 31.00 | 368.48 |
| 2.1835 | -1.2254 | 35.46 | 25.14 | 442.49 |
| … | … | … | … | … |
스프레드시트라고 생각하면 됩니다 — 보통 수만 개의 행(표본)이 있으며, JSON이나 HDF5 파일로 저장되어 numpy·h5py·pandas·PESummary 같은 도구로 바로 불러올 수 있습니다. 표 자체를 눈으로 훑어서는 분포의 모양을 파악하기 어렵기 때문에, 아래 세 가지 표준 시각화를 사용합니다.
참고: Hoy, “Parameter Estimation,” ODW 2026 강의자료, p.50–56
히스토그램 — 파라미터 하나의 분포 읽기
표의 한 열(예: mass_1_source)만 뽑아 히스토그램으로 그리면 그 파라미터의 확률 분포를 바로 볼 수 있습니다. 막대가 높을수록 그 값 근처에 표본이 많이 몰려 있다는 뜻이고, 봉우리 위치가 가장 그럴듯한 값입니다.
히스토그램 위에 흔히 표시되는 점선 두 개는 90% 신뢰구간 의 경계입니다. 논문에 “m₁ = 35.2 ⁺⁴·⁵₋₂·₉”처럼 적힌 값이 바로 이 중앙값과 신뢰구간을 옮긴 것입니다.
실제로 위 Bilby 실습과 같은 방식(nlive=250)으로 GW150914를 분석한 노트북에서, 처프 질량 사후 표본에 대해 90% 신뢰구간을 계산하면 다음과 같은 결과가 나옵니다:
Mc = 30.97 with a 90% C.I = 30.50 -> 31.45
이 경계값을 그대로 히스토그램에 표시하면 아래와 같은 그림이 됩니다 — 주황 음영이 90% 신뢰구간, 굵은 세로선이 중앙값입니다:
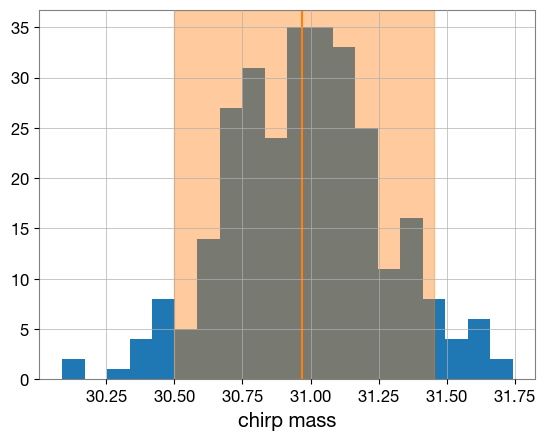
Tuto 5.2 코드 24 출력 — GW150914 처프 질량(chirp mass) 사후 분포 히스토그램. 회색/파랑 막대는 표본의 밀도, 주황 음영은 90% 신뢰구간, 주황 세로선은 중앙값(≈30.97)을 나타낸다.
출처: gw-odw/odw, Tuto 5.2 — Parameter estimation for compact object mergers, 코드 23–24 ↗
코너 플롯 — 파라미터 사이의 상관관계 읽기
파라미터가 여러 개일 때는 각각의 히스토그램만으로는 부족합니다 — 두 파라미터가 서로 얽혀 있는지(하나가 크면 다른 하나도 커지는지, 작아지는지)를 봐야 하기 때문입니다. 코너 플롯(corner plot)은 이를 한 그림에 모두 담습니다:
- 대각선 칸: 각 파라미터 하나만의 히스토그램 — 바로 위에서 본 것과 같습니다.
- 비대각선 칸: 두 파라미터의 2차원 결합 분포. 등고선은 앞서 GWTC-3 그림에서 본 것과 같은 신뢰영역 이며, 짙을수록 표본이 많이 몰려 있는 영역입니다.
예를 들어 m1–m2 칸이 오른쪽 아래로 길게 기울어진 타원이라면, m1이 클 때 m2가 작아지는 경향(음의 상관)이 있다는 뜻입니다 — 실제로 전체 질량은 비교적 잘 정해져 있는데 어느 쪽이 더 무거운지만 불확실할 때 이런 모양이 나옵니다.
이번에는 빠른 실습이 아니라, GWTC-1 논문과 함께 공식적으로 공개된 진짜 사후 표본(IMRPhenomPv2·SEOBNRv3 두 파형 모델의 표본을 동일 개수로 합친 “Overall” 사후 분포 — 논문 본문 그림에 실제로 쓰인 것과 같은 데이터)으로 그린 GW150914 코너 플롯을 살펴보겠습니다. 이번에는 파라미터가 3개(1차 질량 m1, 2차 질량 m2 — 둘 다 천체 프레임, 그리고 적색편이 z)라 3×3 격자로 커집니다:
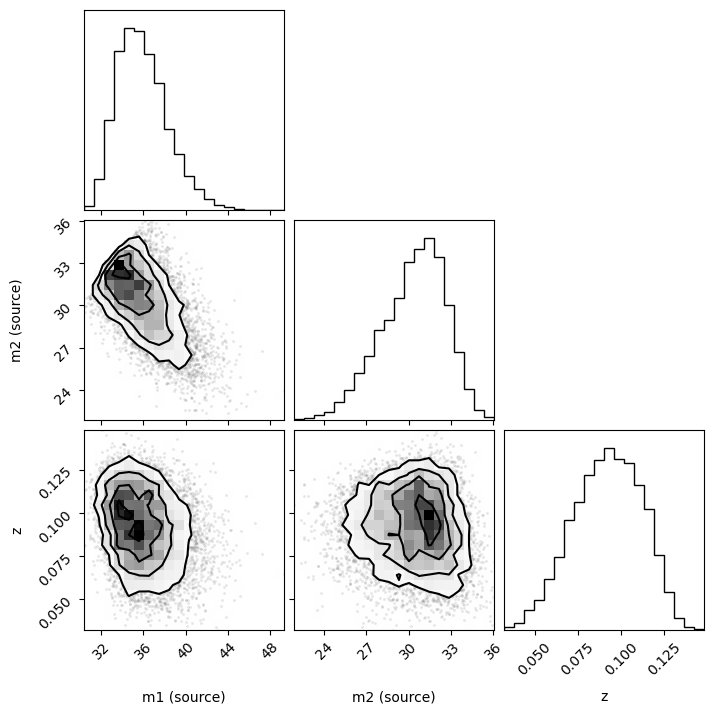
Tuto 5.3 코드 14 출력 — GWTC-1 공식 사후 표본으로 그린 GW150914의 m1(천체 프레임)–m2(천체 프레임)–적색편이 z 코너 플롯. 대각선은 각 파라미터의 1차원 분포, 비대각선은 두 파라미터의 2차원 결합 분포이며 등고선 안쪽일수록 표본이 밀집된 영역이다.
출처: gw-odw/odw, Tuto 5.3 — Discovering and using published posterior samples, 코드 14 ↗
세 가지를 읽을 수 있습니다:
- m1–m2 칸(왼쪽 아래): 앞서 본 것과 같은 오른쪽 아래로 기운 음의 상관관계 — 전체 질량은 잘 정해져 있지만 어느 쪽이 더 무거운지는 불확실하다는 뜻입니다.
- m1–z, m2–z 칸: 질량과 적색편이도 서로 얽혀 있습니다. 그 이유는 이 표에 있는 질량이 원래 검출기에서 잰 값(m_detector)을 로 나눠 구한 천체 프레임 질량이기 때문입니다 — 거리(따라서 z)가 불확실하면 나눠주는 값도 불확실해지므로, 질량과 적색편이의 불확실성이 서로 얽혀 나타납니다.
- z 자체(오른쪽 아래 대각선): 중앙값 0.09 부근, 폭넓은 분포 — GW150914가 비교적 가까운(약 400Mpc) 사건이라 z가 작지만, 거리 측정 자체의 불확실성이 커서 폭이 넓습니다.
질량-적색편이 사이의 이 얽힘은 개별 사건 하나만 볼 때는 사소해 보이지만, 수백 개 사건의 질량 분포를 합쳐 우주론적 결론을 낼 때는 무시할 수 없는 효과가 됩니다 — 이어지는 “질량-적색편이 축퇴” 토글에서 더 자세히 다룹니다.
스카이맵 — 신호가 어디서 왔는가
세 번째 표준 시각화는 하늘 위치(ra, dec) 사후 분포를 지도 위에 그린 스카이맵(skymap) 입니다. 가로축은 적경(ra, 시간 단위), 세로축은 적위(dec, 도 단위)이며, 몰바이데 투영 으로 전체 하늘을 타원 하나에 담습니다. 밝은 띠가 90% 신뢰영역이고, 넓이는 제곱도(deg²)로 표시됩니다.
띠가 둥근 원이 아니라 길게 휘어진 “바나나” 모양인 이유는, 검출기가 2개(H1, L1)뿐이면 신호의 도착 시각차만으로는 하늘 전체에서 원뿔 모양의 후보 영역만 좁힐 수 있기 때문입니다 — 앞서 본 안테나 응답 함수 F₊,ₓ가 검출기마다 다르게 반응하는 차이를 더해야 겨우 이 정도까지 좁혀집니다. 검출기가 3개 이상(+Virgo, KAGRA)이면 삼각측량 원리로 훨씬 좁고 둥근 영역을 얻을 수 있습니다.
실제로 GWTC-1 카탈로그 논문에는 이렇게 만들어진 모든 이벤트의 스카이맵을 한데 모아 놓은 그림이 실려 있습니다:
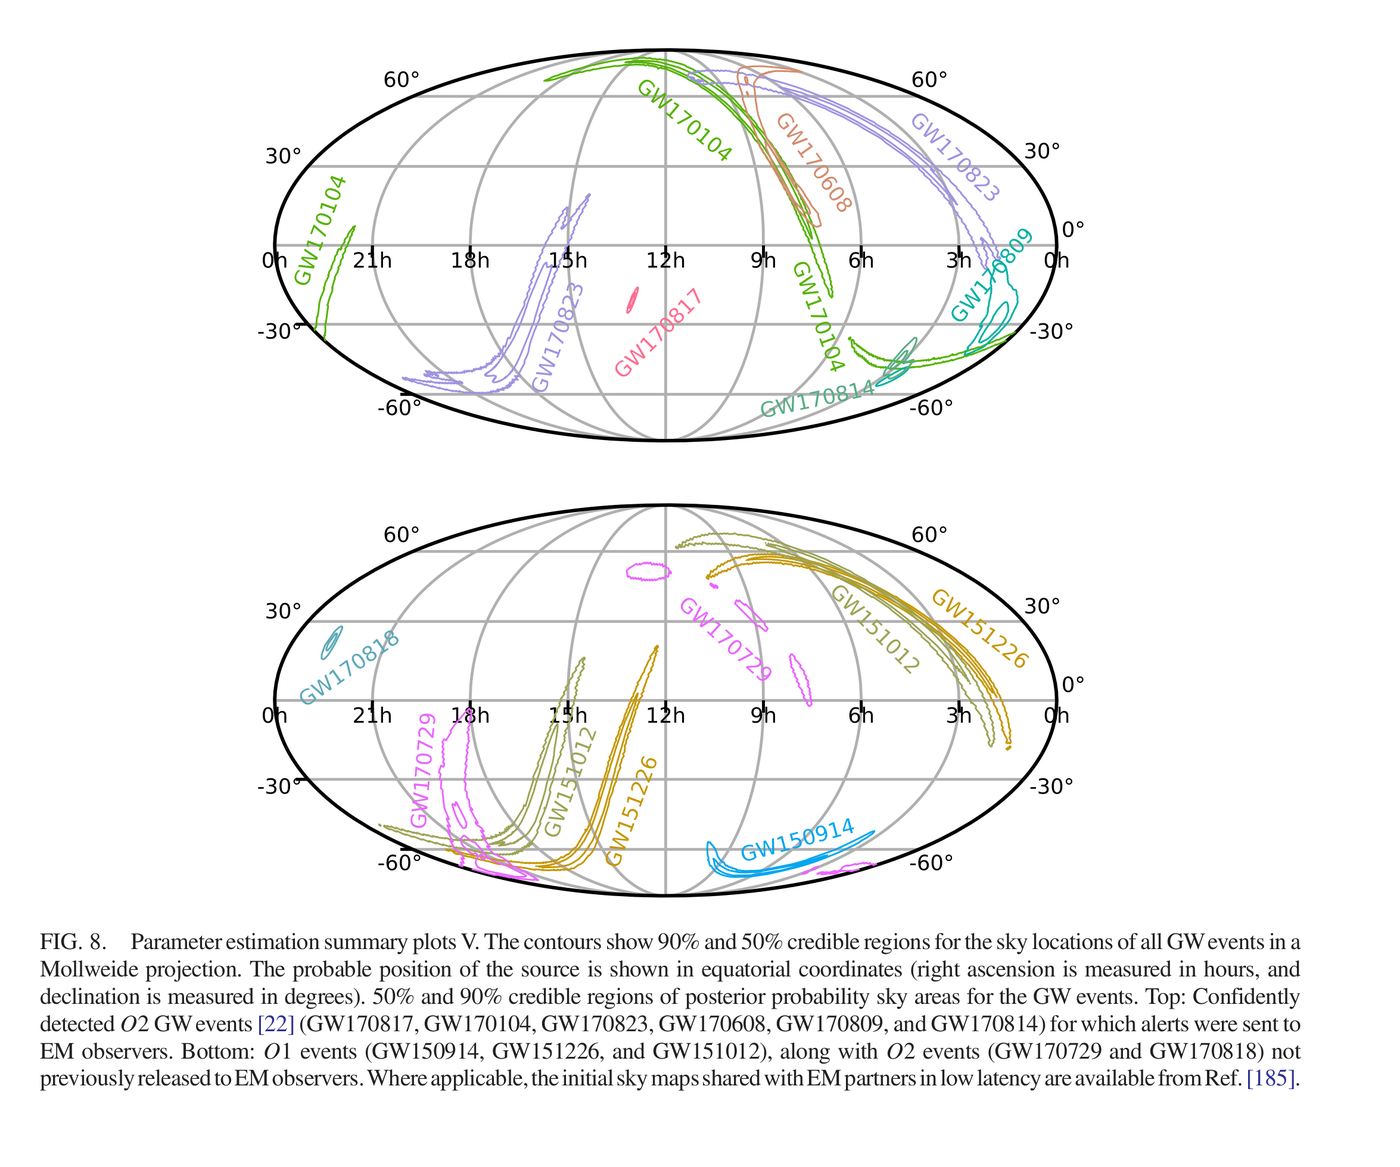
Figure 8 — GWTC-1 전체 이벤트의 하늘 위치 사후 분포(50%·90% 신뢰영역), 몰바이데 투영. 위: 전자기파 관측자에게 경보가 발송된 O2 확인 이벤트(GW170817, GW170104, GW170823, GW170608, GW170809, GW170814). 아래: O1 이벤트(GW150914, GW151226, GW151012)와 이전에 공개되지 않았던 O2 이벤트(GW170729, GW170818).
출처: Abbott et al. 2019 (GWTC-1), Fig. 8 ↗
아래 패널에서 하늘색으로 표시된 GW150914를 찾아보세요 — 지금까지 이 페이지에서 계속 다룬 바로 그 이벤트의 실제 신뢰영역입니다, 예상대로 좁고 긴 띠 모양입니다. 반면 위 패널의 GW170817(분홍색)은 H1·L1·Virgo 세 검출기가 함께 관측해 훨씬 작고 조밀한 점에 가까운 영역으로 좁혀졌습니다 — 검출기 수가 늘수록 하늘 위치가 얼마나 정밀해지는지를 같은 그림 안에서 바로 비교할 수 있습니다.
이해도 확인
지금까지 배운 베이지안 추론과 파라미터 추정 내용을 점검해봅시다.