세션 목록
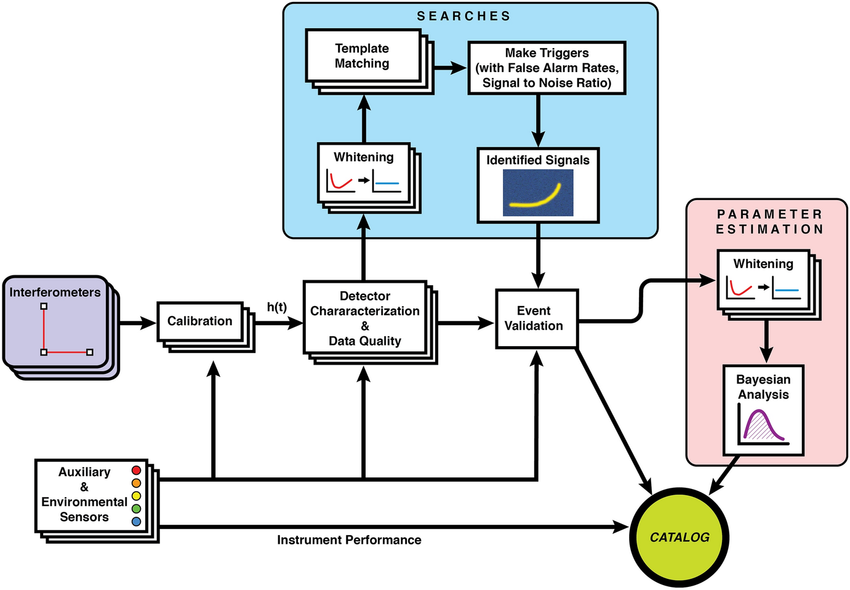
개별 이벤트 추론에서 모집단 추론으로
파라미터 추정(PE)은 "이 신호 하나의 질량·거리·스핀은 얼마인가?"를 묻습니다. 계층적 추론은 한 걸음 더 나아가 "검출된 모든 사건의 질량·스핀·거리 분포는 어떤 물리적 모형에서 나왔는가?"를 묻습니다. 개별 이벤트가 벽돌 하나하나라면, 계층적 추론은 그 벽돌들이 어떤 설계도로 쌓였는지를 역추적하는 작업입니다.
이때 알고 싶은 대상은 모집단 파라미터 입니다 — 멱함수 지수, 병합률, 최대·최소 질량처럼 "모든 이벤트에 공통인 숫자"입니다.
우도를 세 단계로 쌓아 올리기
계층적 우도(likelihood)는 세 단계를 거쳐 완성됩니다 (Vitale, Gerosa, Farr & Taylor 2020의 교과서적 유도 ↗):
1단계 — 완벽한 측정을 가정하면: 잡음이 전혀 없어 각 이벤트의 진짜 파라미터 를 정확히 안다면, 할 일은 그 값을 모집단 모형 에 대입해 평가하는 것뿐입니다.
2단계 — 측정 불확도를 반영하면: 실제로는 각 이벤트의 파라미터가 사후 확률 분포로만 알려져 있으므로, 모집단 모형과 개별 이벤트 우도 를 컨볼루션해야 합니다.
3단계 — 검출기가 완벽하지 않음을 반영하면: LIGO는 모든 합병을 탐지하지 못합니다. 무겁고 가까운 사건일수록 더 잘 검출되므로, 탐지된 카탈로그는 실제 우주 분포를 그대로 반영하지 않습니다. 이 편향은 선택 함수 로 보정합니다.
세 단계를 합치면 계층적 우도의 최종 형태가 나옵니다. 아래는 실제 강의 슬라이드에서 이 세 단계를 정리한 최종 식입니다 — 각 항을 클릭해 무엇을 의미하는지 확인해 보세요:
왜 선택 효과가 중요한가?
보정 없이 탐지된 사건만으로 분포를 그리면 무거운 BH가 실제보다 훨씬 흔한 것처럼 왜곡됩니다 — 더 멀리서도 보이기 때문입니다. 이는 멀름퀴스트 편향과 같은 원리입니다 — 겉보기 밝기만으로 별의 개수를 세면 밝은 별이 과대 집계되는 것과 마찬가지입니다. 다음 섹션에서 이 효과를 실제 강의 슬라이드로 확인하고, 이 다차원 적분을 실제로 어떻게 계산하는지도 함께 살펴봅니다.
선택 효과가 만드는 착시
검출기 감도는 무한하지 않습니다. 무겁고 가까운 BBH일수록 신호가 강해 먼 거리에서도 검출되지만, 가볍고 먼 사건은 잡음에 묻혀 놓칩니다. 그 결과 탐지된 카탈로그는 우주에 실제로 존재하는 진짜 분포를 있는 그대로 보여주지 않습니다.
아래는 이 착시를 실제 논문에서 가져온 예시로 보여줍니다. 광도(luminosity) L을 재는 가상의 서베이에서, 우주에 실제로 존재하는 광도 분포(주황, Population)와 그중 검출 임계값을 넘어 실제로 관측된 분포(파랑, Observed)를 겹쳐 그린 것입니다. 어두운 천체일수록 검출되기 어려우므로, 관측된 분포는 진짜 분포보다 밝은 쪽으로 치우치고 어두운 쪽에서 훨씬 빠르게 줄어듭니다 — 이 왜곡을 보정하지 않으면 “어두운 천체는 원래 드물다”는 잘못된 결론에 이르게 됩니다.
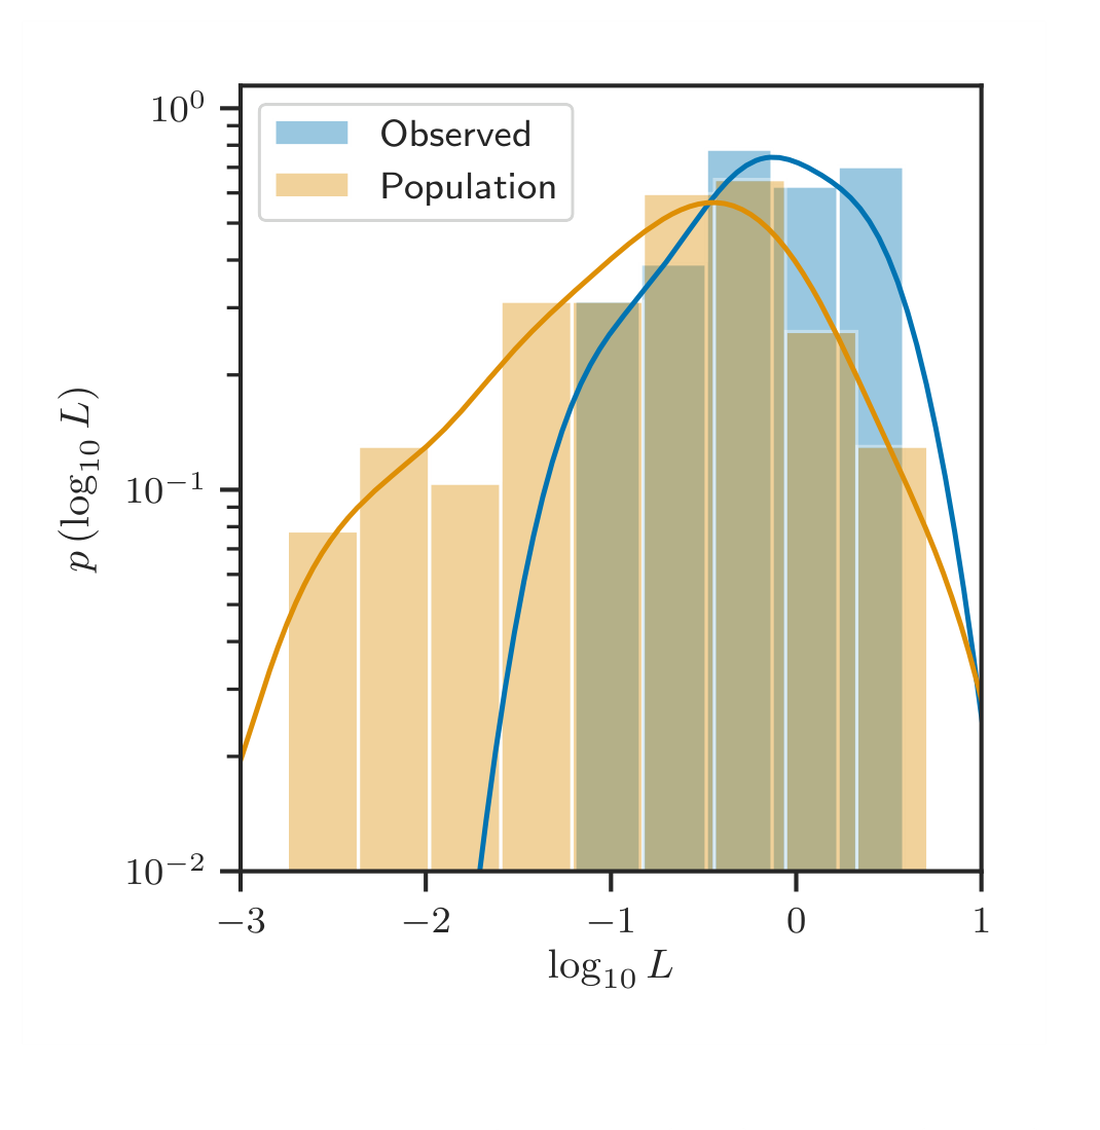
Figure 1 — 가상 서베이에서 관측된(파랑) 광도와 실제 모집단(주황) 광도 분포 비교. 선택 효과 때문에 관측된 분포는 진짜 분포보다 밝은 쪽으로 치우치고, 어두운 쪽에서 더 빠르게 줄어든다.
출처: Mandel, Farr & Gair (2019), Fig. 1 ↗
세 가지 실질적 결론:
- 우리가 모형화하는 것은 내재적 분포(우주에 실제로 존재하는 분포)이지만, 우리가 측정하는 것은 관측된 분포(검출기를 통과한 사건들)입니다.
- 검출기가 거의 보지 못하는 영역은 관측값이 거의 없으므로, 그 구간의 분포는 모형에 의존해 외삽할 수밖에 없습니다.
- 유한한 사건 수 으로만 추론하므로 에는 항상 통계적 불확도가 남으며, 사건이 늘어날수록 이 불확도는 대략 로 줄어듭니다.
몬테카를로 적분 — 다차원 우도를 어떻게 계산하는가
계층적 우도의 분자·분모에는 모두 에 대한 다차원 적분이 들어 있습니다. 질량 2개, 스핀 성분들, 거리, 각도까지 합치면 차원이 10개를 넘기도 해 격자로 직접 적분하는 것은 사실상 불가능합니다. 대신 몬테카를로 적분을 사용합니다.
핵심 아이디어는 간단합니다 — 적분은 평균입니다:
구간 에서 무작위로 뽑은 표본 개의 함수값을 평균 내면 적분값에 수렴합니다. 이를 임의의 분포 에서 뽑은 표본으로 일반화하면 (중요도 표집):
계층적 우도의 분자 적분에 그대로 적용하면:
즉 각 이벤트의 PE 사후 표본(이미 계산되어 있음)을 재활용해 적분을 근사합니다 — 매번 새로 파형을 계산할 필요가 없어 효율적입니다. 분모의 선택 함수 도 같은 방식으로, 실제 주입 신호(injection) 캠페인으로 검출된 표본들을 이용해 근사합니다.
원리 참고: Wikimedia Commons — Monte Carlo integration ↗
왼쪽 패널이 보여주는 것: 정사각형 안에 점을 무작위로 아무렇게나 던진 뒤, 원 안에 떨어진 점의 비율만 세면 원의 넓이(따라서 π)를 알아낼 수 있습니다 — 원의 방정식을 풀거나 넓이 공식을 적분할 필요가 없습니다. 다트를 마구잡이로 던지고 과녁 어디에 꽂혔는지만 세어서 과녁 넓이를 거꾸로 추정하는 것과 같은 원리입니다. 이것이 몬테카를로 적분의 핵심입니다 — “정확히 계산하기 어려운 양”을, “무작위 표본의 비율이나 평균으로 갈음”하는 것입니다.
이해를 돕기 위한 참고자료 → Monte Carlo Integration in a Nutshell (MIT OCW, 2.086) ↗ — 몬테카를로 적분의 수학적 원리(오차 수렴 속도 유도 포함)를 처음부터 차근차근 설명하는 강의 노트입니다.
MCMC와는 어떻게 다른가? 이 페이지 앞부분과 파라미터 추정 페이지에서 나온 MCMC·네스티드 샘플링은 “표본을 어떻게 만들어낼 것인가”를 푸는 도구이고, 여기서 다루는 몬테카를로 적분은 “이미 있는 표본으로 무엇을 계산할 것인가”를 푸는 도구입니다 — 서로 다른 문제를 푸는 두 단계입니다. 실제로 이 둘은 이 페이지에서 사슬처럼 이어집니다: 개별 이벤트 PE 단계에서 MCMC·네스티드 샘플링으로 사후 표본 를 이미 만들어 두었고, 계층적 추론 단계에서는 그 표본들을 “재사용”해 위 중요도 표집 식으로 적분값을 평균 내는 것뿐입니다. 새로 무작위 걸음을 만들 필요 없이, 이미 만들어 둔 점들의 비율(위 데모의 원리 그대로)만 세면 됩니다.
실무적 함정 — 몬테카를로 오차. 표본 수 가 너무 적으면 적분 추정값 자체에 잡음이 섞여 추정이 편향될 수 있습니다. Farr (2019) ↗는 안정적인 결과를 위해 선택 함수 계산에 쓰이는 유효 표본 수가 관측 사건 수의 최소 4배() 이상이어야 한다는 실용적 기준을 제시했습니다.
GWTC 카탈로그로 보는 BBH 모집단 분포 모형
O1–O4b 전체 관측 런에서 검출된 CBC 이벤트는 391개 (GWTC-5.0 기준, 이 중 질량 측정값이 있는 이벤트 282개)이며, 대다수가 블랙홀 쌍성 합병(BBH)입니다. 이 방대한 카탈로그를 하나의 수학적 모형으로 요약한 것이 아래 Power-Law+Peak 모형입니다.
Power-Law + Peak 모형
가장 널리 쓰이는 현상론적 모형은 저질량 영역의 멱함수와 ~35 M☉ 부근의 가우시안 봉우리를 합친 형태입니다:
LVK GWTC-4.0 (2025) ↗ 최적 추정 (158개 사건 기반):
- α ≈ 3.5 (멱함수 지수)
- μ_peak ≈ 34 M☉ (가우시안 피크 위치)
- m_max ≈ 86–100 M☉ 부근
1차 질량(m₁) 분포의 핵심 특징
| 특징 | 관측값 | 물리적 의미 |
|---|---|---|
| 저질량 멱함수 | 기울기 α ≈ −3.5 | 가벼운 BH가 무거운 BH보다 훨씬 많음 |
| 가우시안 피크 | ~34 M☉ (σ ≈ 3.6 M☉) | 특정 형성 경로의 선호 질량 |
| PISN 상한 | ~45 M☉ 이상 급감 | 핵합성 불안정성으로 별이 폭발 |
| IMBH 후보 | m₁ > 100 M☉ | 계층적 합병(GW231123: 137+101 M☉) |
| 하부 질량 간극 | 3–5 M☉ | BNS와 BBH 사이 — 아직 불확실 |
실제 데이터로 본 질량 분포
아래는 LVK GWTC-4.0 (2025)의 Figure 3을 그대로 가져온 것입니다. 세로축은 병합률 미분 , 가로축은 1차 질량 이며, 적색편이 기준으로 평가되었습니다.
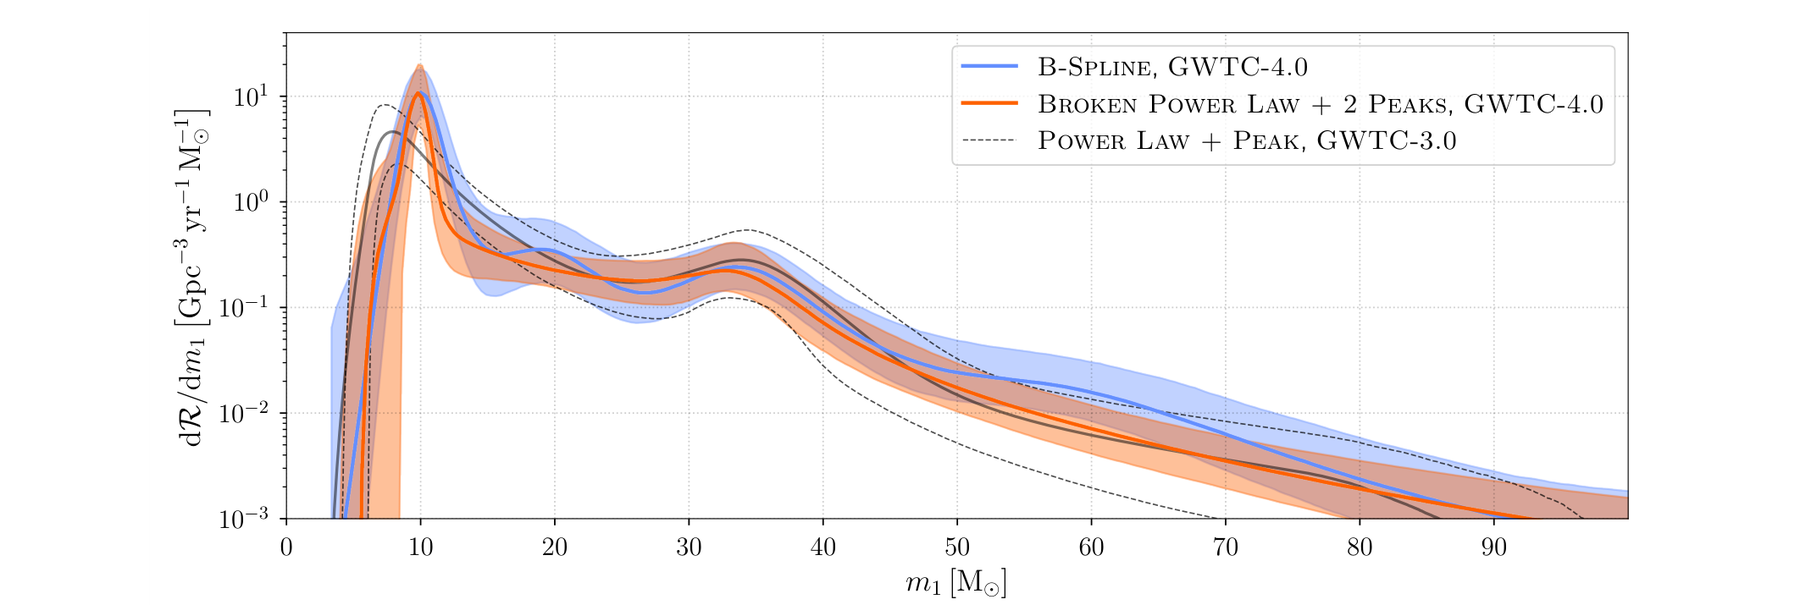
Figure 3 — GWTC-4.0 1차 질량 분포. 주황: Broken Power Law + 2 Peaks 모형(강하게 모형화, 153개 BBH 사건). 파랑: B-Spline 모형(약하게 모형화). 검은 점선: GWTC-3.0의 Power Law + Peak 모형. 실선은 사후 중앙값, 음영은 90% 신뢰구간. 두 독립적인 모형 모두 ~10 M☉ 부근의 전역 피크와 ~34 M☉ 부근의 국소 피크에 동의하지만, GWTC-3.0의 단일 멱함수 모형은 저질량 영역을 제대로 설명하지 못한다.
출처: LVK Collaboration, GWTC-4.0 (2025), Fig. 3 ↗
논문은 이 결과를 이렇게 요약합니다 — "Comparing these results, it is clear that a single power law is a poor description of the low-mass end of the spectrum." (Section 6.1)
핵심 수치 (모두 90% 신뢰구간):
- 전역 피크: Broken Power Law + 2 Peaks 모형은 , B-Spline 모형은 에서 전역 피크를 찾았습니다 — 서로 다른 두 방법론이 독립적으로 같은 결론에 도달했습니다.
- ~35 M☉ 부근 국소 피크: (봉우리) 또는 break mass (기울기가 꺾이는 지점)로 해석 가능
- 저질량/고질량 기울기: 구간의 지수 , 구간의 지수 — 이 97.7% 신뢰도로 성립해, 35 M☉를 기점으로 분포가 뚜렷하게 가팔라짐을 보여줍니다.
Figure 3는 LVK가 공식적으로 발표한 결과지만, 같은 카탈로그를 직접 다뤄보면 이 결과가 어떻게 나오는지 감을 잡을 수 있습니다.
현재 관측 결과로 보는 질량 분포
아래 인터랙티브 플롯에서 실제 GWOSC 데이터로 질량 분포를 직접 확인하세요. Power-Law+Peak 공식 모델과 비교할 수 있습니다. 더 폭넓은 모집단 관측 리뷰는 Callister (2024) ↗를, 최신 카탈로그 공식 분석은 LVK GWTC-4.0 (2025) ↗를 참고하세요 — 이 표의 숫자들이 바로 앞 두 섹션에서 다룬 계층적 우도 를 실제 카탈로그에 적용해 얻은 결과입니다.
모형화 방법론 — 강하게 모형화 vs 약하게 모형화
직접 카탈로그를 조작해 보면 질량 분포의 모양을 요약하는 방식이 하나가 아니라는 것을 알 수 있습니다. Power-Law+Peak처럼 함수 형태를 미리 정하는 접근과, 데이터가 스스로 모양을 결정하게 하는 접근 중 어느 쪽이 나을까요?
| 강하게 모형화 (Parametric) | 약하게 모형화 (Non-parametric) | |
|---|---|---|
| 예시 | 멱함수+가우시안 혼합 (Power-Law+Peak) | 스플라인, 가우시안 혼합, 자기회귀 과정, 적응형 KDE |
| 장점 | 해석이 쉬움 · 빠른 천체물리학적 해석 | 매우 유연함 · 가정에 덜 의존적 |
| 단점 | 계통 오차에 취약 · 사전분포 의존적 | 과적합되기 쉬움 · 외삽이 어려움 |
두 접근을 실제 GWTC-4.0 데이터에 적용한 결과가 위에서 살펴본 Figure 3입니다 — 주황(Broken Power Law + 2 Peaks)이 강하게 모형화된 접근, 파랑(B-Spline)이 약하게 모형화된 접근입니다. 두 방법은 ~10 M☉과 ~34 M☉ 피크의 존재에는 서로 동의하지만, 고질량 꼬리()로 갈수록 B-Spline의 신뢰구간(파란 음영)이 Broken Power Law + 2 Peaks(주황 음영)보다 눈에 띄게 넓게 벌어집니다 — 유연한(약하게 모형화된) 방법일수록 데이터가 부족한 영역에서 불확실성이 빠르게 커진다는 일반적인 트레이드오프를 잘 보여줍니다.
어느 한 방법도 정답은 아닙니다. 여러 독립적인 방법이 같은 결론(예: ~35 M☉ 피크의 존재)에 도달할 때 비로소 그 결과를 신뢰할 수 있습니다 — 이것이 계층적 추론 연구가 여러 모형을 나란히 검증하는 이유입니다.
질량 분포 모형은 우주론 측정에도 그대로 쓰입니다. 관측된 질량이 적색편이와 뒤섞여 나타나는 문제를 아래 토글에서 살펴보세요.
스핀과 적색편이 진화
대부분의 BBH가 작은 유효 스핀 크기를 가지며, 그 분포는 0을 기준으로 양의 방향에 더 넓게 퍼진 비대칭을 보입니다 — 정렬된(격리 진화형) 하위 모집단의 기여를 시사하지만, χ_eff<0인 사건도 상당수(약 34%) 존재해 동적 형성 채널도 함께 기여하는 혼합 모집단으로 해석됩니다 (자세한 수치와 해석은 아래 '현재 관측 결과로 보는 스핀 파라미터 분포'에서 다룹니다).
병합률(merger rate)도 질량 분포 못지않게 중요한 모집단 파라미터입니다. GWTC-4.0은 병합률이 적색편이가 커질수록 증가하는 경향을 확인했으며, 이를 형태로 모형화하면 –3의 값을 얻습니다. 이는 우주의 별 형성률(SFR)이 부근까지 증가하는 추세와 정성적으로 일치합니다 — Madau & Dickinson (2014) ↗의 표준 SFR 모형은 저적색편이에서 에 가까운 기울기를 보입니다. 다만 두 곡선이 완전히 겹치지는 않는데, 별이 태어나 쌍성 블랙홀로 진화하고 실제로 합병하기까지는 수백만 년에서 허블 시간(138억 년)에 이르는 시간 지연이 존재하기 때문입니다. 그 결과 오늘 검출되는 BBH 병합의 상당수는 수십억 년 전에 태어난 별들의 흔적인 셈입니다 (Callister 2024 리뷰 ↗).
현재 관측 결과로 보는 스핀 파라미터 분포
실제 관측된 사건들의 유효 스핀 분포에서는 비대칭(skew) 파라미터 이 99.3% 신뢰도로 선호됩니다 — 다만 이는 대부분의 사건이 양의 스핀을 가진다는 뜻이 아니라, 분포의 봉우리(최빈값)는 0 근처(또는 그보다 살짝 왼쪽)에 있으면서도 꼬리가 양의 쪽으로 더 길게 뻗어 있다는 뜻입니다. 실제로 인 사건의 비율도 약 34%에 달해(GWTC-4.0 논문 표 3), 결코 무시할 수 있는 소수가 아닙니다. GWTC-4.0 논문 ↗ (§6.3.2)은 이 비대칭을 정렬된 하위집단의 기여로 해석하면서도, 같은 절(§6.3.1)에서 궤도면 기준 90도 이상 오정렬된 스핀을 가진 사건이 전체의 20–40%에 달한다고 보고합니다 — 저자들은 이로부터 전체 BBH 모집단이 단일 형성 채널에서 왔을 가능성은 낮다고 결론짓습니다. 정렬된 성분과 오정렬된 성분이 함께 섞인 이 패턴은 Day 2 CBC 천체물리학에서 다룬 격리 진화·동적 형성 어느 한쪽만으로는 설명되지 않습니다.
| 관측량 | 격리 진화 예측 | 동적 형성 예측 | GWTC-4.0 결과 |
|---|---|---|---|
| 분포 | , 좁은 분포 | , 넓고 대칭 | 대체로 작은 스핀 + 양의 비대칭(99.3% 신뢰도), 그러나 인 사건도 약 34% |
| 질량비 | 비대칭 가능 | 대체로 | |
| 고질량 BBH | 드물다 (PISN) | 계층적 합병으로 가능 | GW190521 등 극소수 |
이해도 확인
계층적 추론의 핵심 개념을 점검해봅시다.